在真实问题里,检验技术的价值。在真实问题里,检验技术的价值。
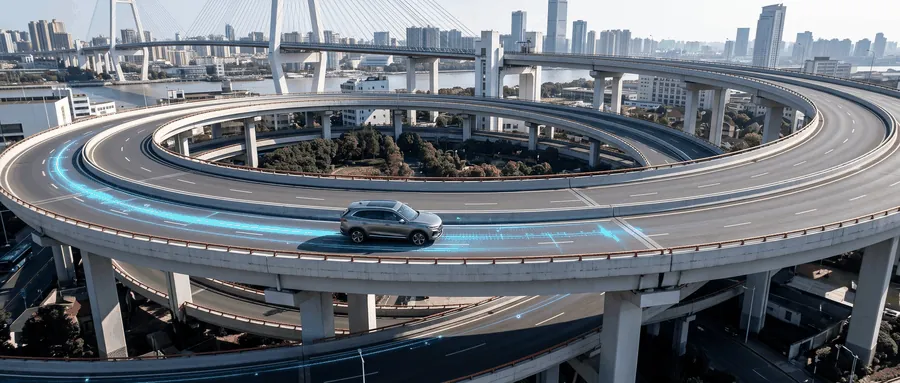
曾经我对智驾挺不屑,觉得安全还是得捏在自己手里。这个周末租了辆车,第一次靠高速领航跑完了全程长途:几个环叠在一起的复杂匝道没出错,堵车跟车、打灯变道、自动超车都比预期稳。但边界也很清楚——雨天看不清车道线时无法启用,收费站加塞会要求接管,车道巡航既不认红绿灯也不跟导航走,自动泊车试了多次都没成功。智驾确实能给驾驶做减法,但当下最合理的仍是人机共驾。
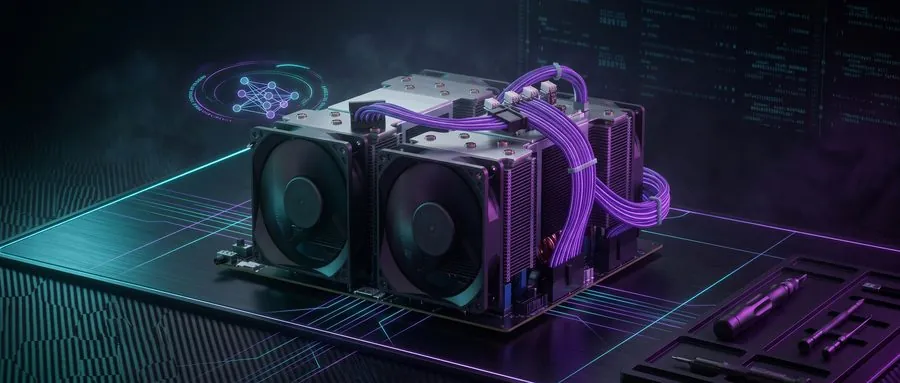
用两块 NVIDIA Tesla V100 SXM2 16GB 显卡、转接主板、8654 交叉线和定制机箱,组装出一块 32GB 的巨大显卡,并在 Ubuntu 24 下以 62 tokens/s 的速度运行 35B 千问模型。文章记录完整的硬件清单、散热与装机过程,也聊聊本地部署的成本、电费和模型选择。
一份超过3万字的产品文档让AI处理,AI竟然用脚本批量处理,结果重复、粗糙、AI 味严重。重新拆解任务并让多个模型并行处理、由强模型统一审查后,文档质量明显提升,也让我找到了一套处理复杂长任务的方法。
一个月在 Codex 中消耗约 17 亿 Token 后,罗孚按不同模型计算理论 API 成本,重新思考对强模型的依赖,以及模型分层、自建模型和会员杠杆背后的真实投入产出。
同样使用 Codex,Windows 和 macOS 的差别究竟在哪里?Codex CLI 又是不是桌面端的简化版?真正影响体验的,不是模型换了一个大脑,而是开发环境带来的摩擦,以及执行工具与任务管理台之间的分工。
Loops、Goal、超长任务和多 Agent 描绘了 AI 自主完成工作的未来,但在今天,目标定义、路径拆解、过程检查、最终验收和风险责任仍离不开人。真正的 AI 自主,不是运行更久或调用更多 Agent,而是在越来越多的关键节点上不再需要人类接管。
人人都能指挥 AI 干活,但不同的人得到的结果依然相差很大。模型决定能力上限,工具决定执行效率,而人的表达力、基础知识和判断力,最终决定 AI 能不能真正把事情做好。
一篇文章的每一个字都由 AI 生成,是否还算自己的创作?结合一次真实的公众号写作经历,罗孚重新思考 AI 辅助写作、个人思想与作品归属之间的关系。AI 可以整理和升华文字,但真正决定文章价值的,仍然是创作者独有的经历、判断与思想。
一场关于AI预测彩票与股市的对话,扯出了科技演进的冷酷终局:AI作为“复杂性消化器”,正以强大的数据融合能力降维打击传统“玄学”场景。但在金融等博弈生态中,绝对理性的同质化AI极易引发集体踩踏与市场闪崩。当技术将已知确定性榨干到极致,市场的终点反而会坍缩回一个由纯粹未知主导的“新玄学”。
Google推出年付100美元限时特惠PRO会员,不仅解锁最强AI模型、生图工具、编程工具等,更支持5人共享,性价比极高;建议重度AI用户或家庭拼车入手。